准备
- 一些钱(至少100元)
- xshell / xftp (ssh sftp管理工具)
- 一些 ai 模型
- indextts2.5 / git / caddy / …
其实之前9月的时候跑了一次 indextts2.5 ,但是那次我的blog站点还没完全做好,所以也没记录,这次想测试一下项目,所以正好顺便一起补一下。
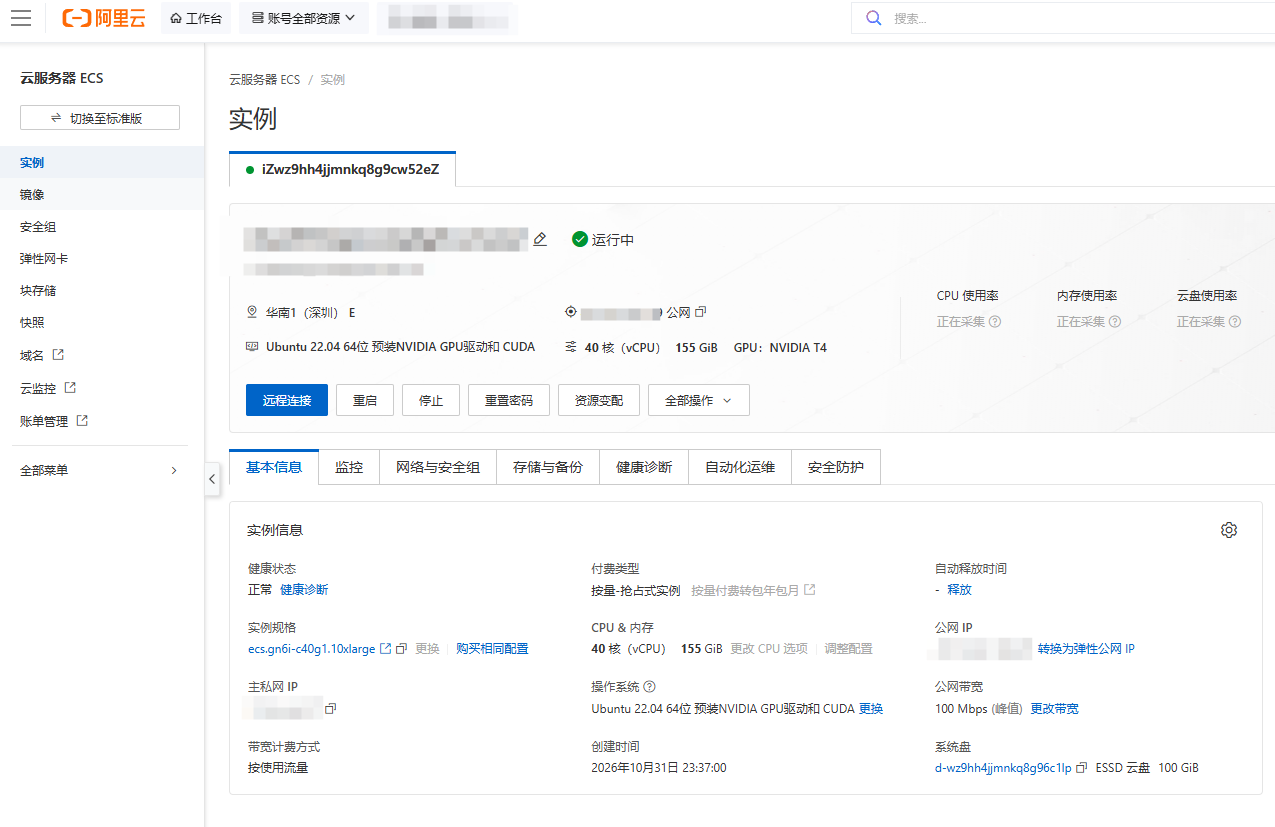
因为手头没有卡,然后直接租的云GPU,使用一张 T4 的 16G 显存,足够跑 indextts2.5 (实测最高只需要 12G 显存)
上传 indextts2.5 离线部署包
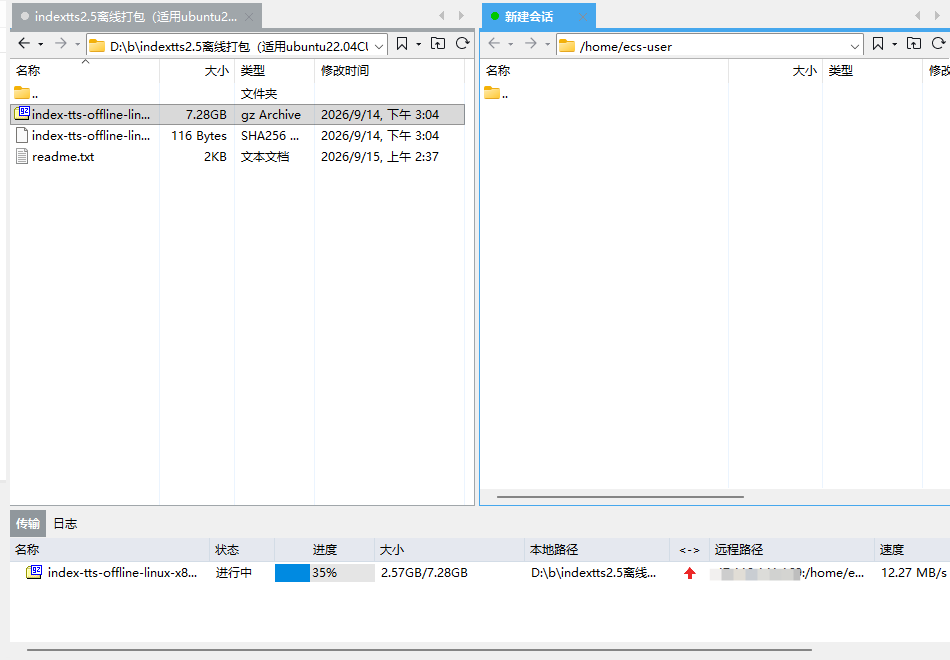
上传事先本地打包好的 indextts2.5 离线包,国内云服务器装依赖非常麻烦,因为网络问题,所以事先用 GPT 5.6 sol 帮我打包好了 indextts2.5 的离线包,用在 ubuntu 22.04 cuda12.8 刚刚好。indextts2.5 是8月出的,打包时间9月,所以正好就直接使用 2.5 版本,一个离线包7G多(不包含主模型),100Mbps上传时间10分钟左右,也不算慢,因为考虑到抢占式主机开销,启动一次估算至少20块钱,上传好到部署,只要不超过半个小时就不算亏。
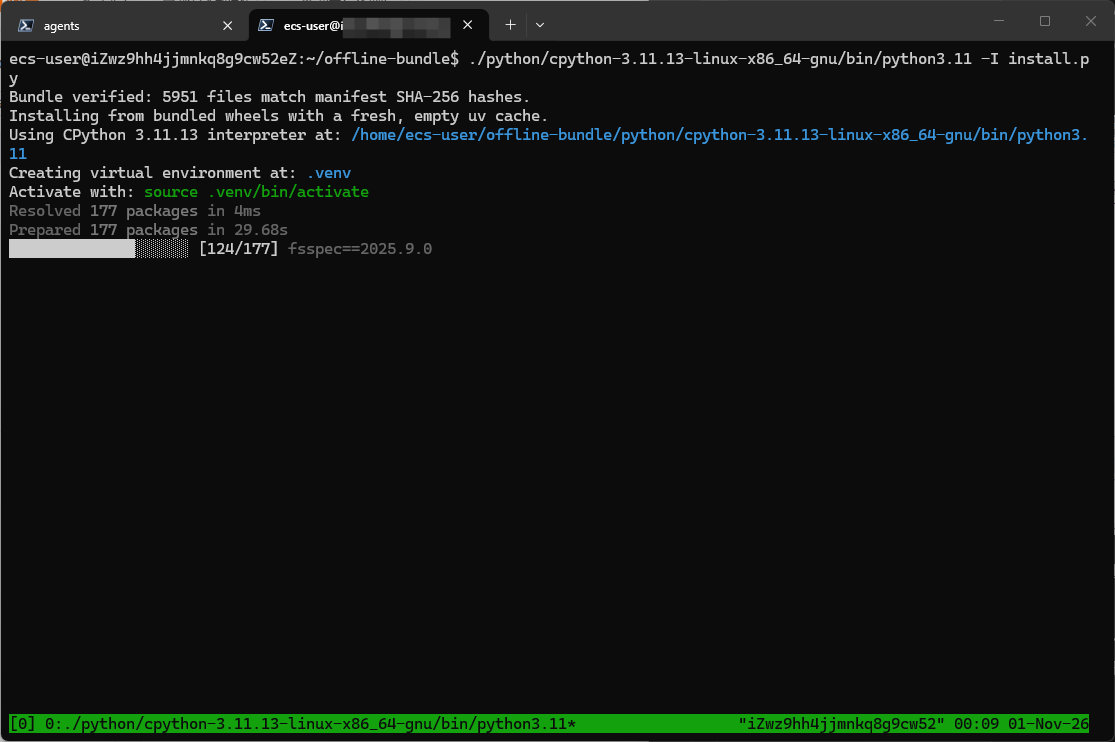
(离线安装依赖中)
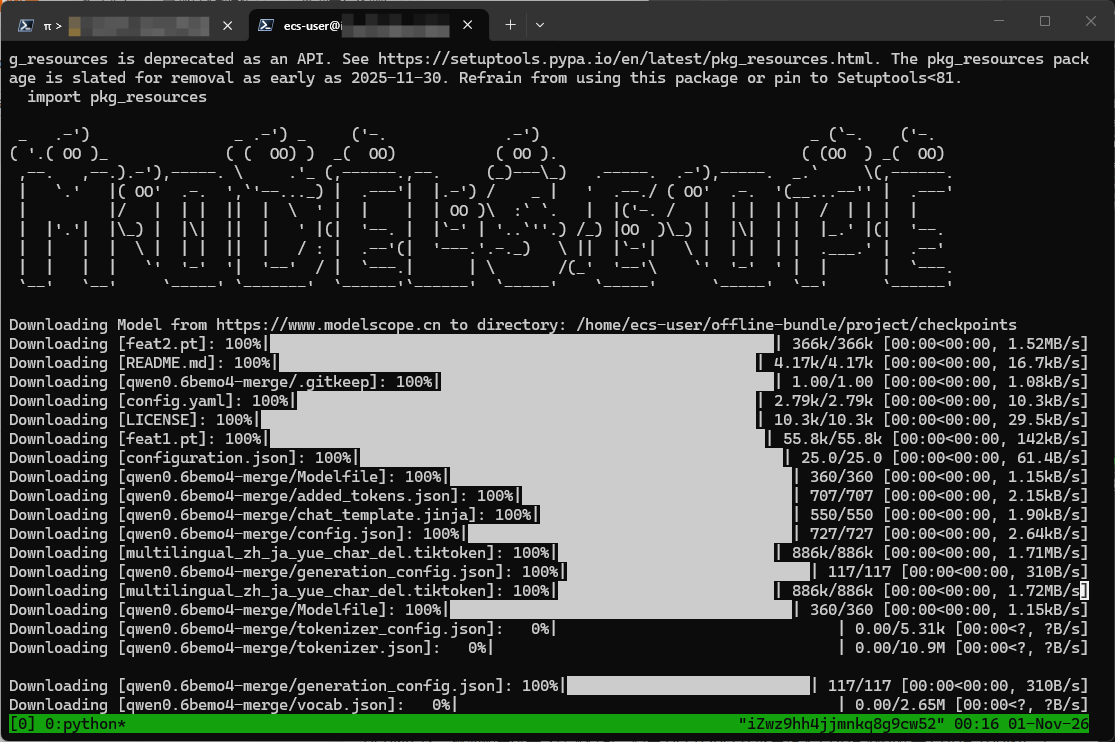
indextts2.5 模型本身不在打包中,因为模型在 modelscope 国内平台能直接下载,速度也能非常快,云服务器下载速度甚至有加成,本次未体现,上次在杭州服务器上,下载速度能达到上百 MB/s ,几乎感觉就是光速下载完成。
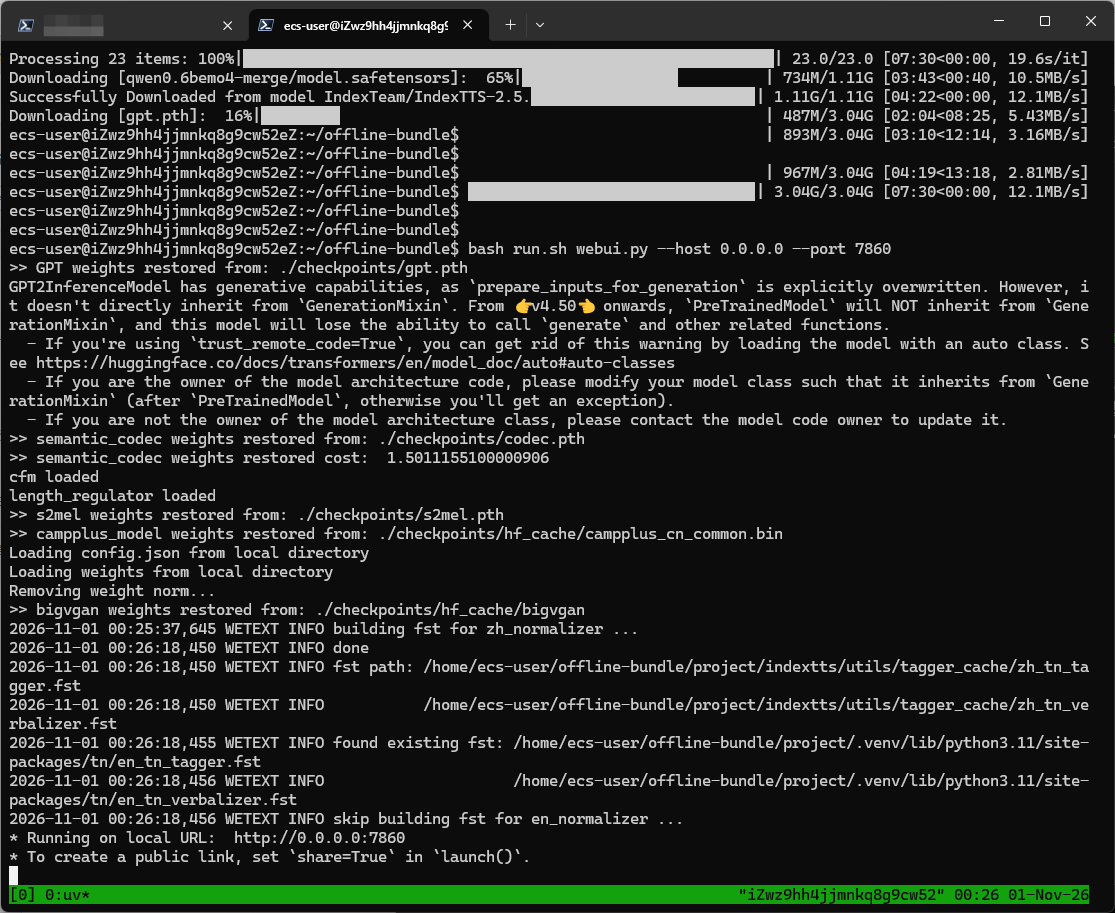
下载完模型,直接启动 webui.py ,出现 webui 前端地址后就说明可以访问了。
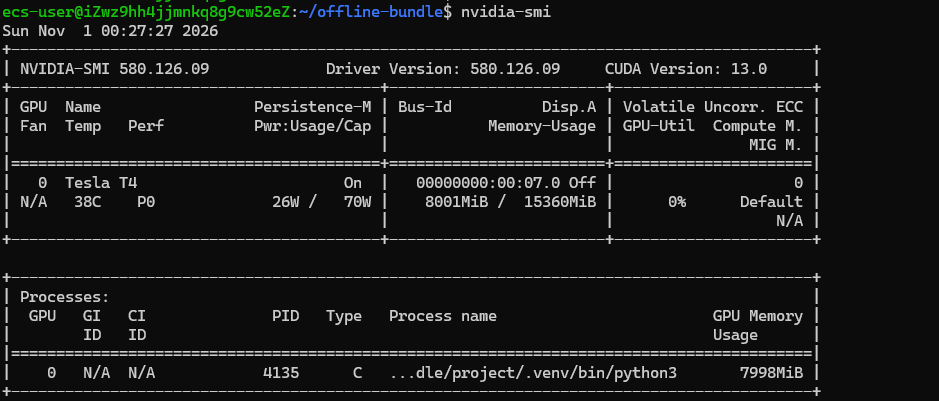
通过 nvidia-smi 查看显卡占用可以看到,加载 indextts2.5 需要至少8G的显存。
套个 caddy 在公网安全访问
根据 caddy 官网手动安装 caddy ,因为 ubuntu 默认没有 caddy 软件源。
公网防火墙一般默认 22 80 443 ,我自己用会多加个 8443 ,indextts2.5 默认端口是 7860 ,我肯定不会把它直接开放在公网,但是为了方便使用肯定是直接使用公网访问,所以我用caddy直接套个反代然后加个简单的auth验证。自己简单使用肯定是没有问题了。
实测能力
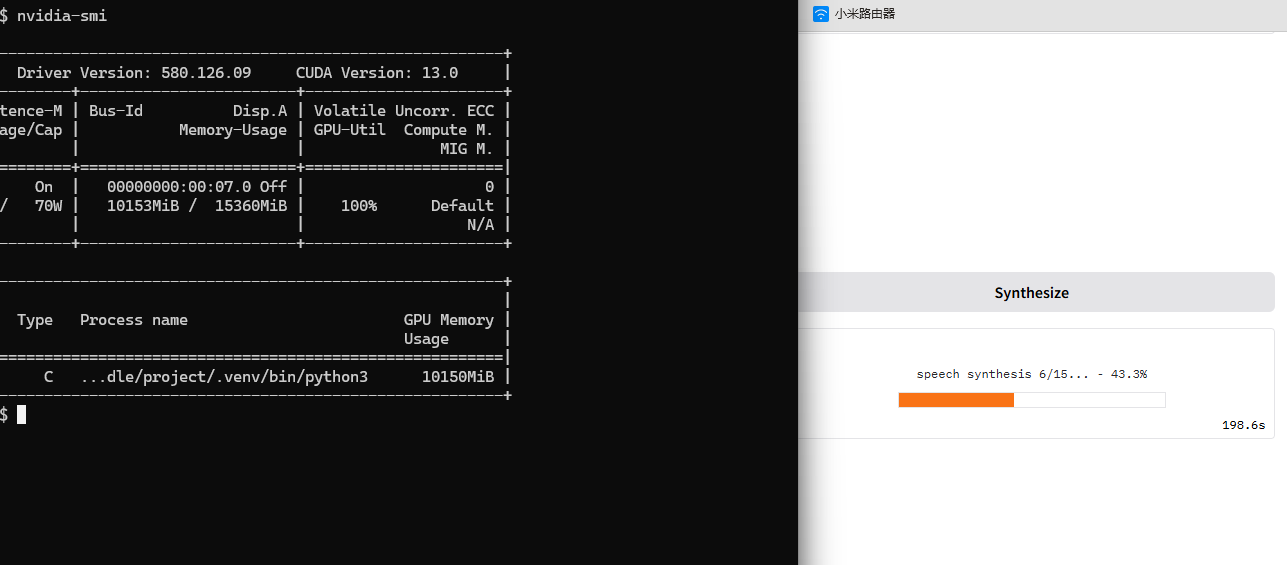
这里我用了一段源 5min 的样本,同时附带样本的字幕,T4的生成时间大概是这种感觉和占用,姑且可以参考一下。如果是用 RTX 3060 ,速度不一定会更快,虽然综合来说 3060 这张卡性能更好,12G显存,但 T4 毕竟是工业卡,效率这块没得比。
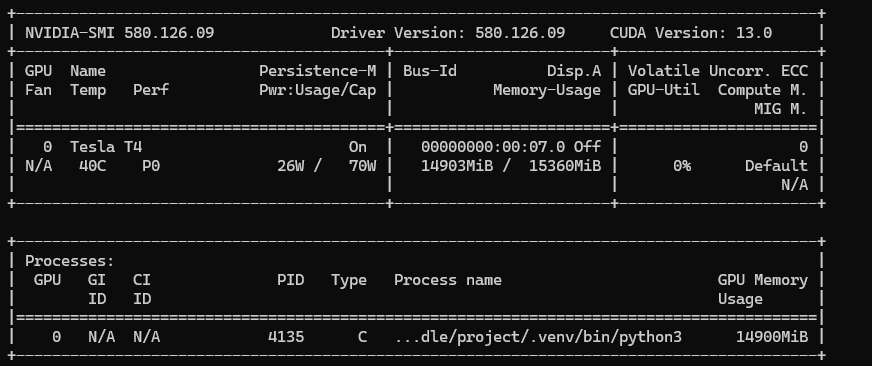
5min 样本最终,也会超过14G显存,这是预料里没有的。